Trajectory решает реальную проблему: генеральные модели OpenAI, Anthropic и open source как они есть не учатся на ошибках без переобучения. Компании вынуждены либо нанимать дорогих инженеров-консультантов (forward-deployed engineers), либо держать свои ML-команды. Результат — дорого и медленно, особенно для юристов, докторов, финансистов, которым нужна специализированная модель.
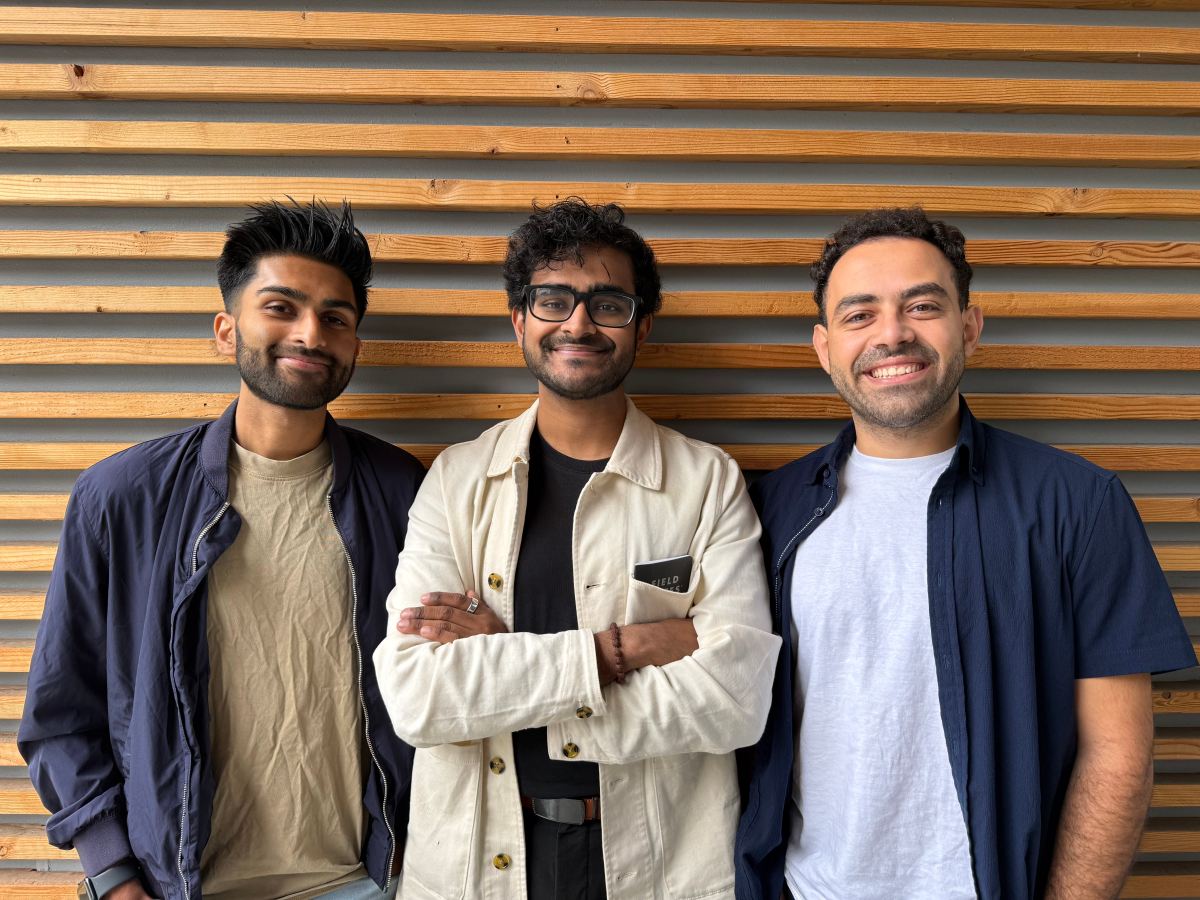
Стартап, основанный год назад тремя выпускниками Stanford с опытом в Google DeepMind и Apple, предлагает другой подход. Их платформа собирает фидбэк на работе модели прямо в production и использует его для переобучения — так модель постепенно становится экспертом в конкретной задаче. Harvey (для права) и Rogo (для финанса) уже используют это для адаптации open source моделей под работу с контрактами и оценкой компаний. Интерфейс платформы заточен так, чтобы с ней работали люди без ML-опыта — это критичный момент для mass market.
Инвестиция $45M (Sequoia вел, Nvidia и Bessemer учитывают) показывает, что рынок видит масштаб: если это действительно работает и дешевле hiring FDE, то спрос огромный. Но тут нужно честно сказать: continual learning в production — это не новая идея, и доказывать, что она work reliably, нужно на деле, не на обещаниях. Trajectory конкурирует с Thinking Machines Lab (бывший CTO OpenAI Мира Мурати), Applied Compute ($3.25B оценка) и Prime Intellect. Преимущество Trajectory в команде — те же люди, которые работали над этим в DeepMind.
Софт-трек компании (люди из OpenAI, Stripe, Netflix наняли для UI/UX) говорит о том, что основатели понимают: в ML-инструментах UX часто упускают, хотя именно он определяет, пойдёт ли продукт в широкое распространение. Это хороший знак, но не гарантия. Нужно дождаться кейсов, где модель действительно дешевле и быстрее, чем нанять consultants.
По модели recursive self-improvement — улучшение AI без человека — соучредитель Elabd прямо говорит, что они намеренно держат людей в loop. Это не идеология, а практика: autonomous self-improvement может сломаться непредсказуемо. Разумно.
