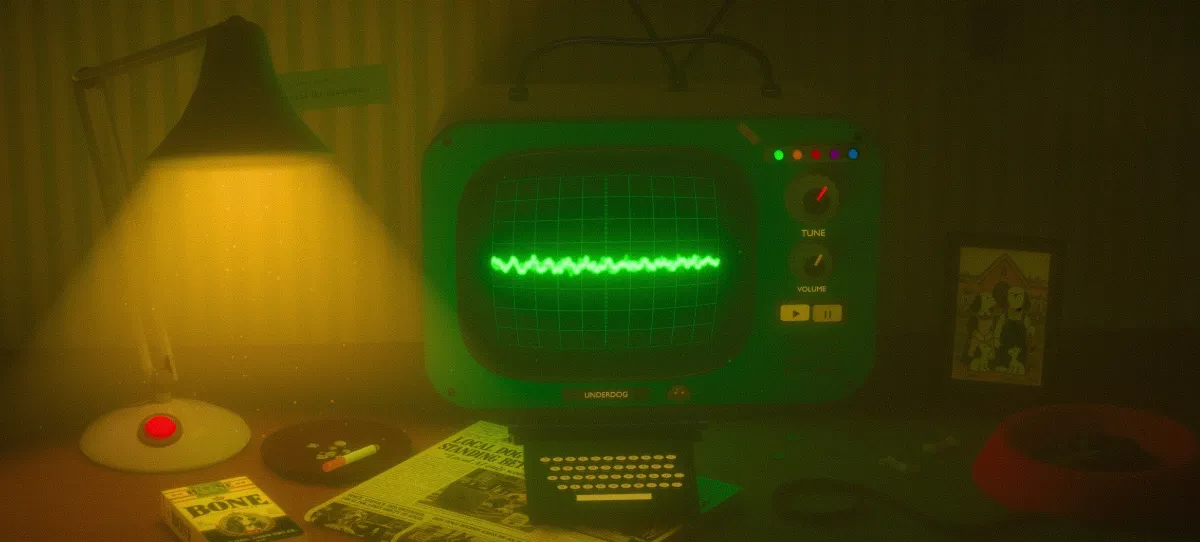
Стартап Underdog выкатил интерактивную игру, построенную на своей новой речевой модели Woof объёмом 31.7 МБ — пока это одна из самых компактных функциональных моделей текст-в-речь на рынке. Игра запускается прямо в браузере, весь синтез речи происходит локально, без отправки данных на серверы. Пользователь может печатать на виртуальной пишущей машинке, и модель проговаривает текст разными голосами; также в игре есть музыкальный синтезатор.
Главный смысл демо не в развлечении, а в демонстрации принципа: современные LLM и речевые модели не обязательно должны быть многогигабайтными облачными монстрами. Woof содержит 31 млн параметров, весит меньше среднего PDF-документа и работает на большинстве устройств без интернета. Компания выложила модель открыто для скачивания.
Это уже второй релиз Underdog за короткий срок. Несколько недель назад они представили Bark — модель speech-to-text объёмом 167 МБ для локальной транскрипции и диктовки. Плюс к этому в разработке 27-миллиардная параметровая модель, которая якобы должна хорошо работать на ноутбуках. Основатель стартапа Sigil Wen говорит, что вообще видит будущее, когда мощные ИИ-модели будут работать локально на уже имеющихся устройствах пользователя.
Тренд на edge-моделям реален и логичен: облачные решения требуют зависимости от провайдера, плохо справляются с задержками и приватностью, дорогие в масштабе. Но нужно быть честным: 32 МБ модель, конечно, не заменит GPT-4 или Google Gemini. Это инструмент для вполне конкретных задач — личные голосовые ассистенты, локальные подкасты, диктовка записей. В этом диапазоне она работает, и качество вполне практическое.
Для российского бизнеса локальные модели становятся всё актуальнее в контексте санкций и ограничений на использование иностранных облачных сервисов. Компании, которые собирают речевые данные клиентов (call-центры, сервисы диктовки, чат-боты), могут рассмотреть встраивание таких компактных моделей вместо зависимости от OpenAI или Google. Правда, сейчас это требует собственной инженерной работы — платформ вроде AI Studio можно автоматизировать контент и обработку данных, но для специфичной речевой обработки с локальными моделями нужна кастомная интеграция.
Главный вопрос здесь — масштабируемость качества. Можно ли натренировать edge-модели так, чтобы они конкурировали не только по размеру, но и по качеству синтеза? Underdog утверждает, что «большинство способных моделей современности» будут запускаться на личных устройствах в течение месяцев. Это звучит оптимистично, но реальность обычно сложнее. Тем не менее, даже если итоговое качество останется ниже облачных аналогов, для множества задач приватность и независимость могут быть важнее идеальной точности.

Алексей Мартыненко
Главный редактор SPV News
Компактные модели — не альтернатива большим, а решение для конкретного использования. 32 МБ модель в браузере это практично для локальной диктовки или персонального ассистента, но не вытеснит облачные GPT-подобные сервисы. Важнее тренд: наконец, начинают серьёзно работать над тем, чтобы ИИ-инструменты работали на устройстве пользователя, а не требовали отправки всех данных в чужое облако.