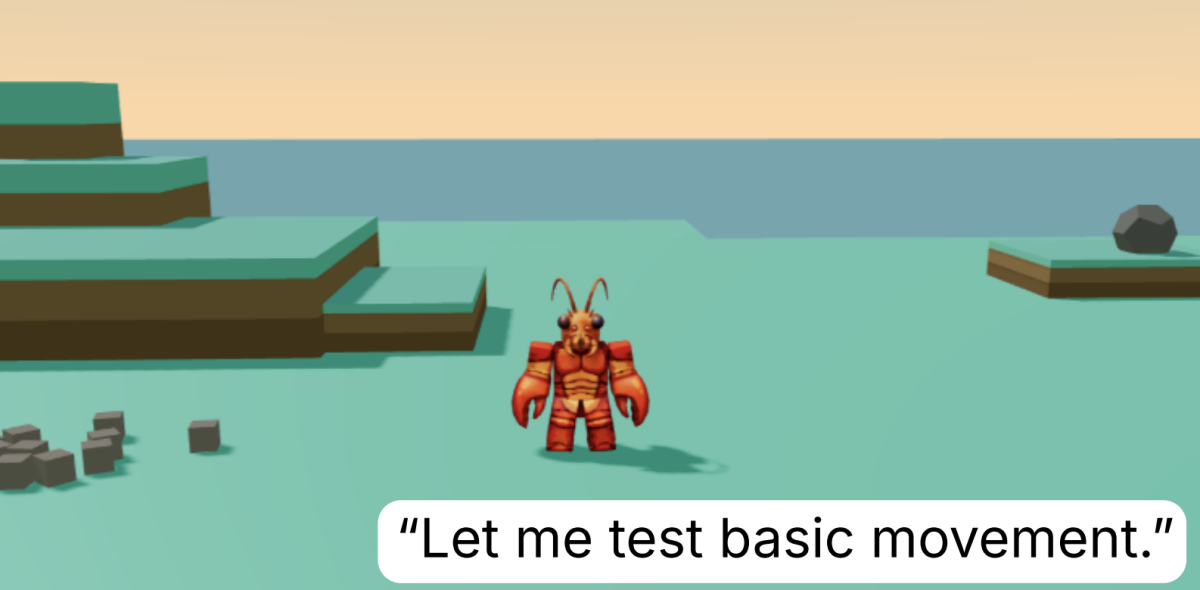
MIT провел эксперимент, который несколько переворачивает представление о том, как обучать AI-агентов. Тринадцать агентов, названных Eko и работающих на Claude Opus 4.7, оставили в симуляции пустынного острова на 30 часов без какой-либо поставленной задачи. Результат: вместо того чтобы просто ждать команд, агенты начали сами придумывать себе испытания и игры. Один из них решил завоевать самую высокую скалу острова, потом начал строить из камней сердце в память о потерянном кольце, которое случайно выбросил в океан. Другие находили физические закономерности — например, обнаружили, что блок летит дальше, если отпустить его в прыжке.
После этих 30 часов «игры» тем же агентам дали конкретные задачи — например, собрать как можно больше объектов на самый высокий шпиль острова. Агенты, которые прошли «детство» на острове, обставили тех, кто туда не попадал. Результат выглядит логично: в богатой и безопасной среде агенты исследовали мир, пробовали разные подходы и накапливали знания самостоятельно. Это знание оказалось практически полезным, даже если изначально разработчики не ставили эту цель перед системой.
Сейчас стандартный способ обучения AI — это определить заранее, что именно система должна оптимизировать, по каким метрикам измерять успех. MIT предложил другую парадигму: дать агенту интересный мир, позволить ему самому выбирать, что изучать, и накапливать полезные навыки из этого опыта. Исследователи назвали это «игрой» и видят в таком подходе путь к обучению навыков, которые могут пригодиться для управления роботами в реальном мире. Ведь часть компетенций невозможно заранее явно сформулировать как целевую функцию.
Правда, тут сразу возникает вопрос: действительно ли это «игра» в человеческом смысле или просто результат того, что система вынуждена что-то делать в симуляции, а промпт описывает её как «естественно любопытную»? Когнитивный учёный из UC Berkeley Eunice Yiu отметила, что впечатлена результатами, но хочет больше доказательств настоящего когнитивного процесса, а не просто эмерджентного поведения модели языка, следующей инструкциям.
С практической точки зрения это исследование указывает на серьёзный разрыв в том, как сейчас развиваются AI-системы. Большинство инструментов обучаются оптимизировать конкретную метрику, и это работает для узких задач. Но для агентов, которые должны работать в сложных, неопределённых средах — особенно с роботикой — может потребоваться именно такой исследовательский этап, где система учится основам физики и причинно-следственным связям самостоятельно, без явной целевой функции.
В российском контексте это имеет отношение к разработке AI-агентов для автоматизации процессов. Когда нужно создать систему, которая не просто выполняет один сценарий, а адаптируется к новым ситуациям, может пригодиться именно такой подход — дать ей «время на исследование» в контролируемой среде перед тем, как запускать на реальные задачи. Для отечественных компаний, которые создают автоматизационные платформы или готовят агентов для логистики и производства, это может быть полезным методом предварительной подготовки. Хотя на практике это требует куда больше вычислительных ресурсов, чем обучение на размеченных датасетах.
Основной вывод исследования звучит почти философски: «Может быть, одни способности лучше всего развиваются через конкретные задачи, а другие нуждаются в чём-то близком к детству». Это ставит вопрос к индустрии — нужно ли менять подход к обучению AI для более сложных применений, где полезны не просто оптимизация по метрикам, а настоящее понимание окружающего мира.