Когда ИИ-чатбот даёт неправильный ответ, пользователь переформулирует вопрос. Когда автопилот или боевой дрон принимает неверное решение, последствия совсем другого масштаба: разбитый беспилотник, авария, потеря миссии. Это ключевое различие между ИИ в интернете и ИИ в физическом мире — граница между неудобством и катастрофой. Вопрос, который давно волнует индустрию: как понять, что система готова к боевому применению, а не только к лабораторным испытаниям?
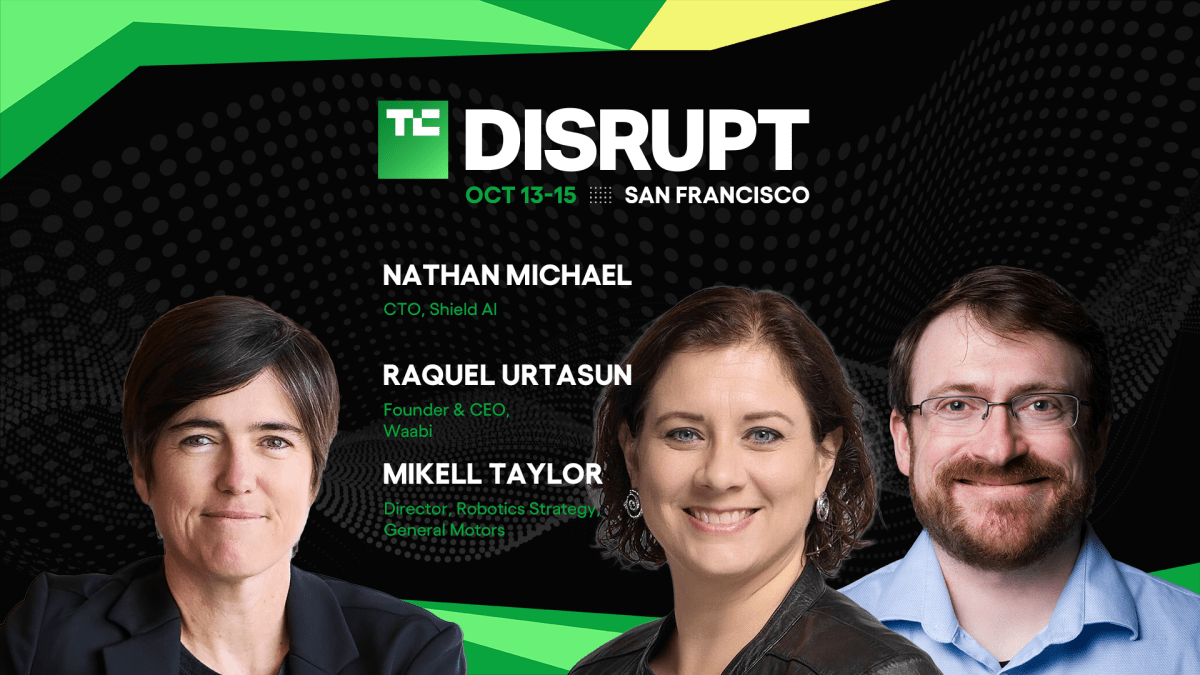
На конференции TechCrunch Disrupt 2026 этот вопрос обсуждать будут три специалиста, работающих именно с такими системами. Nathan Michael из Shield AI возглавляет разработку Hivemind — платформы для автономии дронов, которую в феврале выбрала ВВС США для программы боевых беспилотников. Raquel Urtasun из Waabi отвечает за валидацию технологии автономного вождения и недавно объявила о партнёрстве с Uber на 25 тысяч роботакси. Mikell Taylor из General Motors руководит робототехникой компании и ранее возглавляла разработку автономных мобильных роботов в Amazon. Все трое работают в областях, где недостаточно быть близким к готовности — нужна уверенность.
Суть дискуссии упирается в конкретные инженерные и организационные вызовы. Как строить культуру безопасности, если риск реален? Как тестировать систему так, чтобы симуляция не подводила в реальности? Waabi, например, использует собственный симулятор Waabi World для стресс-тестирования автономных грузовиков в виртуальной среде перед физическим развёртыванием — но сама компания неоднократно повторяла, что полная валидация должна быть завершена до начала безводительских операций. Shield AI, в свою очередь, разрабатывает системы для военной авиации, где стандарты ассurance заведомо выше, чем в большинстве гражданских отраслей.
За последние два года тема валидации ИИ для критичных систем вышла из категории «интересный вопрос» в категорию «бизнес-требование». General Motors получила штраф за спешку с развёртыванием беспилотных сервисов, Waymo и Cruise столкнулись с регуляторной блокадой, когда общественное доверие рухнуло после нескольких инцидентов. Параллельно в военной робототехнике требования к надёжности только ужесточаются. Эта сессия важна не потому, что даёт готовые ответы, а потому, что показывает, как практики из разных отраслей (оборона, транспорт, промышленность) решают один и тот же класс проблем: как перейти от «система работает в тестах» к «система готова работать, когда ошибка имеет реальные последствия».
Для российского бизнеса этот вопрос пока остаётся гипотетическим в гражданском секторе — текущее регулирование беспилотных такси и грузовиков находится в стадии экспериментов. Однако в оборонной промышленности и критичных инфраструктурных системах (например, промышленная робототехника, системы мониторинга) вопрос валидации ИИ уже встаёт перед разработчиками. Для компаний, которые создают автономные системы или внедряют ИИ-решения в процессы, где отказ системы приводит к потерям, мастерство в валидации становится конкурентным преимуществом. Здесь работают не только с открытыми моделями и фреймворками, но и выстраивают собственные протоколы тестирования и документацию, сопоставимую по строгости с авиационными или автомобильными стандартами.
Историческая справка: вопрос надёжности ИИ в высокорисковых задачах возник не вчера. В авиации, где автопилоты и системы помощи пилотам уже десятилетия влияют на безопасность, выработались жёсткие стандарты (DO-254, DO-178C). Но ИИ, особенно на основе deep learning, сложнее верифицировать, чем традиционные встроенные системы: нейросеть нельзя полностью протестировать на всех возможных входах. Это означает, что валидация становится комбинацией симуляции, реальных испытаний, формального анализа и оценки остаточного риска. Shield AI, Waabi и GM работают в сценариях, где этот вызов наиболее острый, — и их подходы интересны именно как раз потому, что они не универсальны и требуют адаптации под контекст.