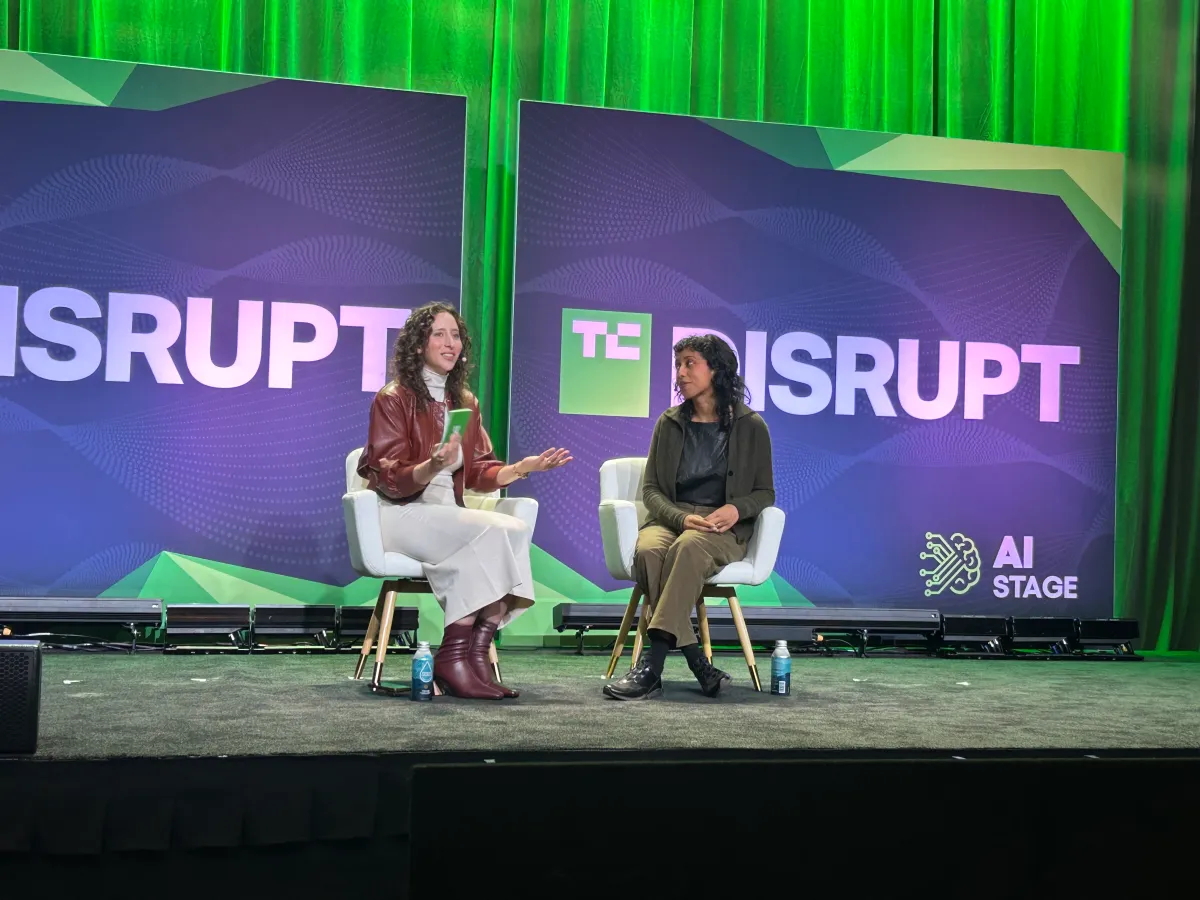
Лаборатории ИИ долго полагались на бенчмарки как на якобы объективный способ оценить, какая модель лучше. Но за последние месяцы стало ясно, что инструментарий этот далеко не совершен. Ирен Соламан, главная политолог Hugging Face, на конференции TechCrunch Disrupt прямо сказала: методология оценок слишком сложная и всё ещё развивается. Если индустрия хочет полагаться на эти тесты в будущем, нужно привести их к единому научному стандарту.
Воспроизводимость результатов — давно известный узкий момент в бенчмаркинге, и спор о нём не утихает. Соламан подчеркнула главное: можно ли повторить результаты оценки? Есть ли доступ к самой модели? Вот тут на помощь приходят открытые веса моделей. Но и это не решает проблему полностью: даже если ты воспроизвел один тест, остаётся непонятным, как этот результат соотносится с другими оценками. «Это развивающаяся наука, где мы не знаем, как осмысленно сравнивать разные тесты между собой», — отметила она.
На фоне этого возникла мода на «встроенные оценщики» — якобы нейтральных третьих лиц, которые должны сидеть внутри лабораторий и следить за безопасностью моделей. Идея стала популярна в последние месяцы, когда AI-компании столкнулись с серией скандалов и хотели избежать жесткого государственного регулирования. Сама Hugging Face была жертвой одного из таких инцидентов. Однако скептицизм вполне обоснован: когда Anthropic наняла консалтинговую фирму Accenture в качестве первого оценщика, это вызвало волну критики. Не ясно, почему консультант по управлению должен быть авторитетом в оценке безопасности ИИ.
Соламан указала на ещё одну проблему: оценки сместились с самой модели на экосистему вокруг неё — интерфейсы, агентов, инструменты доступа. Инструмент, через который пользователь общается с моделью, часто решает больше, чем сама модель. Слабая модель с хорошим интерфейсом может легко обойти лучшую моделей, если у той плохой интерфейс. И вот тут оценки становятся действительно сложными и дорогими. «Оценки агентских систем очень трудозатратны, — сказала Соламан. — У нас есть куча оценок моделей, но намного меньше оценок для интерфейсов и комплексных агентских систем, а именно из них люди получают реальную пользу».
Сегодня рынок оценок — это полный беспорядок, и каждый делает что-то своё. Если индустрия хочет, чтобы бенчмарки оставались авторитетным инструментом, нужна единая методология, где все бы двигались в одном направлении. Вопрос в том, кто будет устанавливать эти стандарты и будет ли индустрия их соблюдать.
В России эта проблема пока не столь острая, так как локальный рынок LLM-оценок только развивается, но она станет актуальной, когда российские компании начнут разрабатывать и лицензировать собственные модели. При создании внутренних систем оценки качества (для контента, автоматизации процессов или безопасности) имеет смысл уже сейчас закладывать стандартизированный подход: документировать методологию, обеспечивать воспроизводимость и разделять тесты модели, интерфейса и конечной системы. Это убережёт от того, чтобы позже переделывать оценочные системы с нуля.
По оценке политического руководства индустрии, встроенные независимые оценщики — это не альтернатива регулированию, а приложение к нему. И работать будут только в том случае, если за ними стоит прозрачная, воспроизводимая и единая методология. Пока таковой нет, доверие к результатам любого такого оценщика будет оставаться под вопросом.