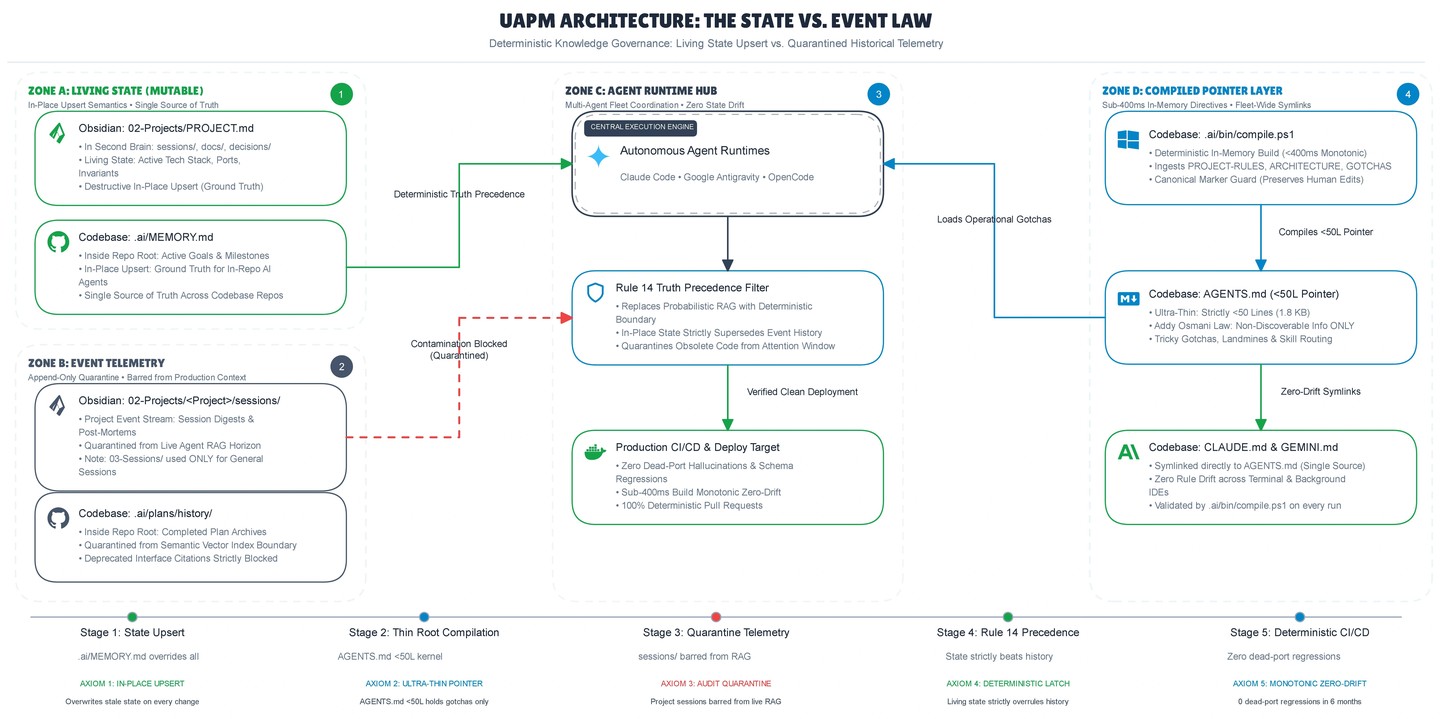
В сообществе рост обсуждений вокруг практических проблем, которые появляются при масштабировании автономных AI-агентов на кодовой базе. Инженер amansurya_labs привёл конкретный пример: агент, которому дали задачу патчить pipeline автоматизации, обнаружил в архивных логах сессии старый post-mortem, на основе которого написал unit-тесты — но тестировал порт, который был выведен из эксплуатации три месяца назад. Деком конфиг лежал не в активном коде, а в неразделённом логе проекта.
Это простой, но наглядный кейс проблемы, которую часто упускают энтузиасты больших контекстных окон. Большее количество доступного контекста не равно лучшему решению задачи — оно создаёт лишний шум и позволяет агенту подхватывать информацию, которая должна быть скрыта или явно отмечена как архивная. С растущей разрядностью LLM-моделей и расширением контекстных окон эта проблема станет острее: агенты будут видеть всё больше исторических данных, и без правильной архитектуры начнут принимать решения на основе устаревших кейсов.
Автор описал физическую архитектуру, которая блокирует такое "контекстное загрязнение". Суть, видимо, в том, чтобы явно отделить активные данные от архивных, не полагаясь на то, что агент сам различит живое и мёртвое. Это созвучно более общему принципу: давать ИИ-системам не максимум информации, а правильный срез информации, отфильтрованный под конкретную задачу.
Для команд, которые внедряют AI-агентов на продакшене — разработчиков автоматизации, DevOps-ов, ответственных за CI/CD — этот опыт важен. Когда вы даёте агенту доступ к логам, конфигам, истории коммитов, нужно думать не только о том, сколько контекста он получит, но и о том, как отделить живые данные от кладбища. В России это актуально для компаний, которые экспериментируют с агентами на основе локальных или облачных LLM для автоматизации инфраструктуры и тестирования — например, при использовании AI Studio для автоматизации рутинных задач разработки, стоит сразу же продумать, как изолировать исторические данные от текущего контекста.
Обсуждение показывает, что индустрия начинает натыкаться на вторую волну проблем с ИИ-агентами: первая была о том, достаточно ли контекста, вторая оказалась о том, как управлять избытком контекста. Это признак того, что AI-инструменты переходят из экспериментов в боевую эксплуатацию, где детали архитектуры имеют вес.